¿Necesita una IA un lenguaje de programación humano?
Mikodawa R&D
Una investigación sobre representaciones de software diseñadas para agentes de IA.
Mikodawa Runtime investiga si una representación diseñada para agentes puede reducir la distancia entre lo que pedimos y el software que finalmente se ejecuta.
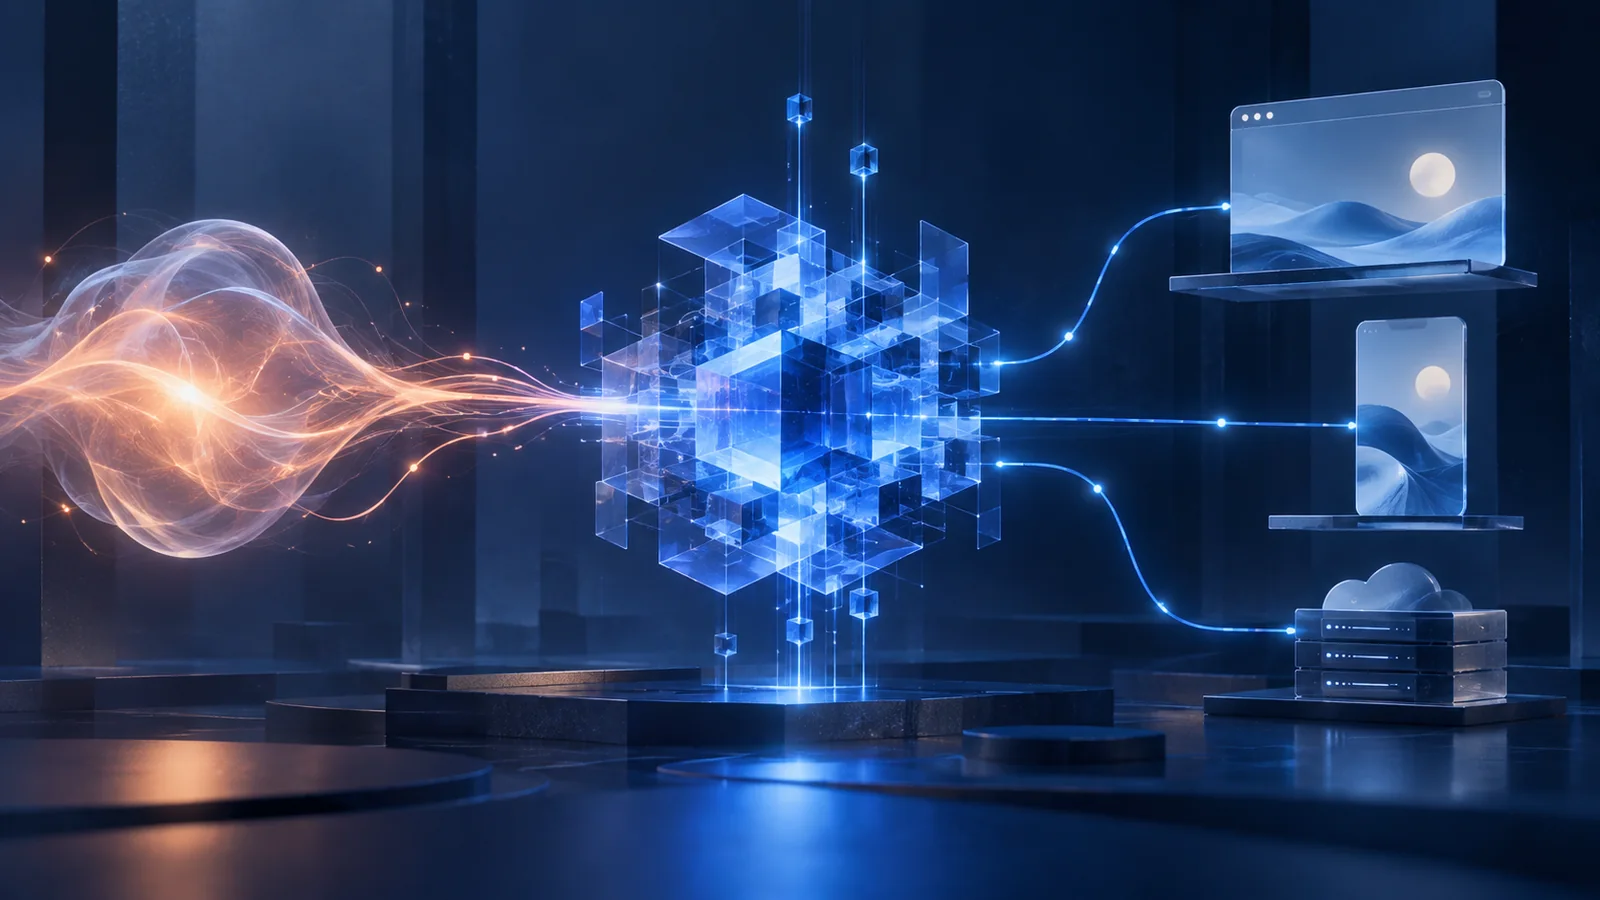
Los lenguajes de programación son una interfaz: permiten que una persona describa instrucciones de forma comprensible y mantenible. Pero una inteligencia artificial no lee, recuerda ni transforma información como nosotros. La pregunta de Mikodawa Runtime es si esa misma interfaz debe seguir siendo obligatoria cuando quien programa es un agente.
01 · Punto de partida
La pregunta detrás de Runtime
Hoy utilizamos modelos de IA para producir React, TypeScript, CSS, SQL o PHP: los mismos lenguajes que creamos para que los humanos pudiéramos trabajar con las máquinas. Es una estrategia razonable y extremadamente útil. También puede esconder una suposición que rara vez examinamos: que la mejor representación para una persona tiene que ser también la mejor representación para una IA.
Mikodawa Runtime nace para poner esa suposición a prueba. La hipótesis es que un agente podría trabajar con una representación de software más estructurada, compacta y verificable: una capa intermedia capaz de expresar intención, componentes, estado, relaciones, acciones y restricciones. Runtime transformaría después esa estructura en aplicaciones ejecutables para web, backend, móvil o servicios.
Si una IA no necesita programar exactamente como una persona, quizá podamos reducir la distancia entre la intención y la ejecución.
Esa frase no es una conclusión. Es la hipótesis de trabajo. Todavía no sabemos si esa representación consumirá menos tokens, cometerá menos errores o facilitará las modificaciones. Precisamente por eso el proyecto empieza por construir cómo medirlo.
02 · Una analogía útil
El código también es una interfaz
Un compilador ya transforma el lenguaje que escribe un desarrollador en otras representaciones antes de producir instrucciones ejecutables. El código fuente no es la máquina: es una forma humana de describirla. Mikodawa Runtime explora un giro sobre esa idea: ¿y si la representación inicial pudiera estar pensada para la forma de trabajar de un agente?
Intención
Objetivo y restricciones
Runtime IR
Estructura verificable
Targets
Web, móvil, API y más
Separar intención e implementación podría permitir que una misma definición se proyectara sobre varios destinos. También podría hacer visibles contradicciones que hoy quedan dispersas entre cientos de archivos. Pero una capa nueva solo merece existir si demuestra una mejora medible frente a los lenguajes y herramientas que ya funcionan.
03 · El orden importa
Por qué construir Studio antes que Runtime
Diseñar primero un lenguaje y pedir después a una IA que se adapte a él sería empezar por la respuesta. Nuestro enfoque invierte el proceso: observar cómo programan los agentes, identificar sus fricciones recurrentes y diseñar una representación que responda a evidencia real.
Mikodawa Studio cumple dos funciones. Puede convertirse en un producto para crear aplicaciones a partir de lenguaje natural y, al mismo tiempo, actúa como laboratorio. En él podemos ejecutar el mismo encargo con motores distintos, controlar el entorno, registrar cada operación y evaluar el resultado con las mismas pruebas.
Producto y banco de pruebas
Studio es la superficie que usa la persona. Agent Core ejecuta el trabajo. El motor inferior podrá ser código tradicional o Mikodawa Runtime sin cambiar el benchmark.
04 · Lo que falló primero
El modelo no era todo el problema
Las primeras versiones de Studio podían construir proyectos pequeños, pero se detenían ante instrucciones más exigentes. Era tentador atribuir cada fallo al modelo. Al revisar las ejecuciones descubrimos que parte importante del problema estaba en el sistema que lo rodeaba.
01
Contratos demasiado rígidos
Una aplicación podía estar creada y validada, pero el run se marcaba como fallido si el mensaje final no coincidía con una forma textual exacta.
02
Contexto inflado
Archivos completos y resultados de herramientas se reenviaban una y otra vez hasta convertir una tarea modesta en cientos de miles de tokens.
03
Límites artificiales
El agente se detenía por un máximo bajo de llamadas, incluso cuando estaba progresando y solo necesitaba una iteración adicional.
04
Validación incompleta
HTML, CSS y JavaScript válidos no garantizan una interfaz legible, responsive o funcional en un navegador real.
Hubo una señal especialmente útil. Una landing mal maquetada mejoró de forma notable después de una instrucción tan breve como «se ve mal, arréglala». El modelo tenía capacidad para corregir; necesitaba conservar mejor el contexto, observar el resultado y disponer de margen para iterar.
05 · Un nuevo plano de ejecución
Studio Agent Core 2.0
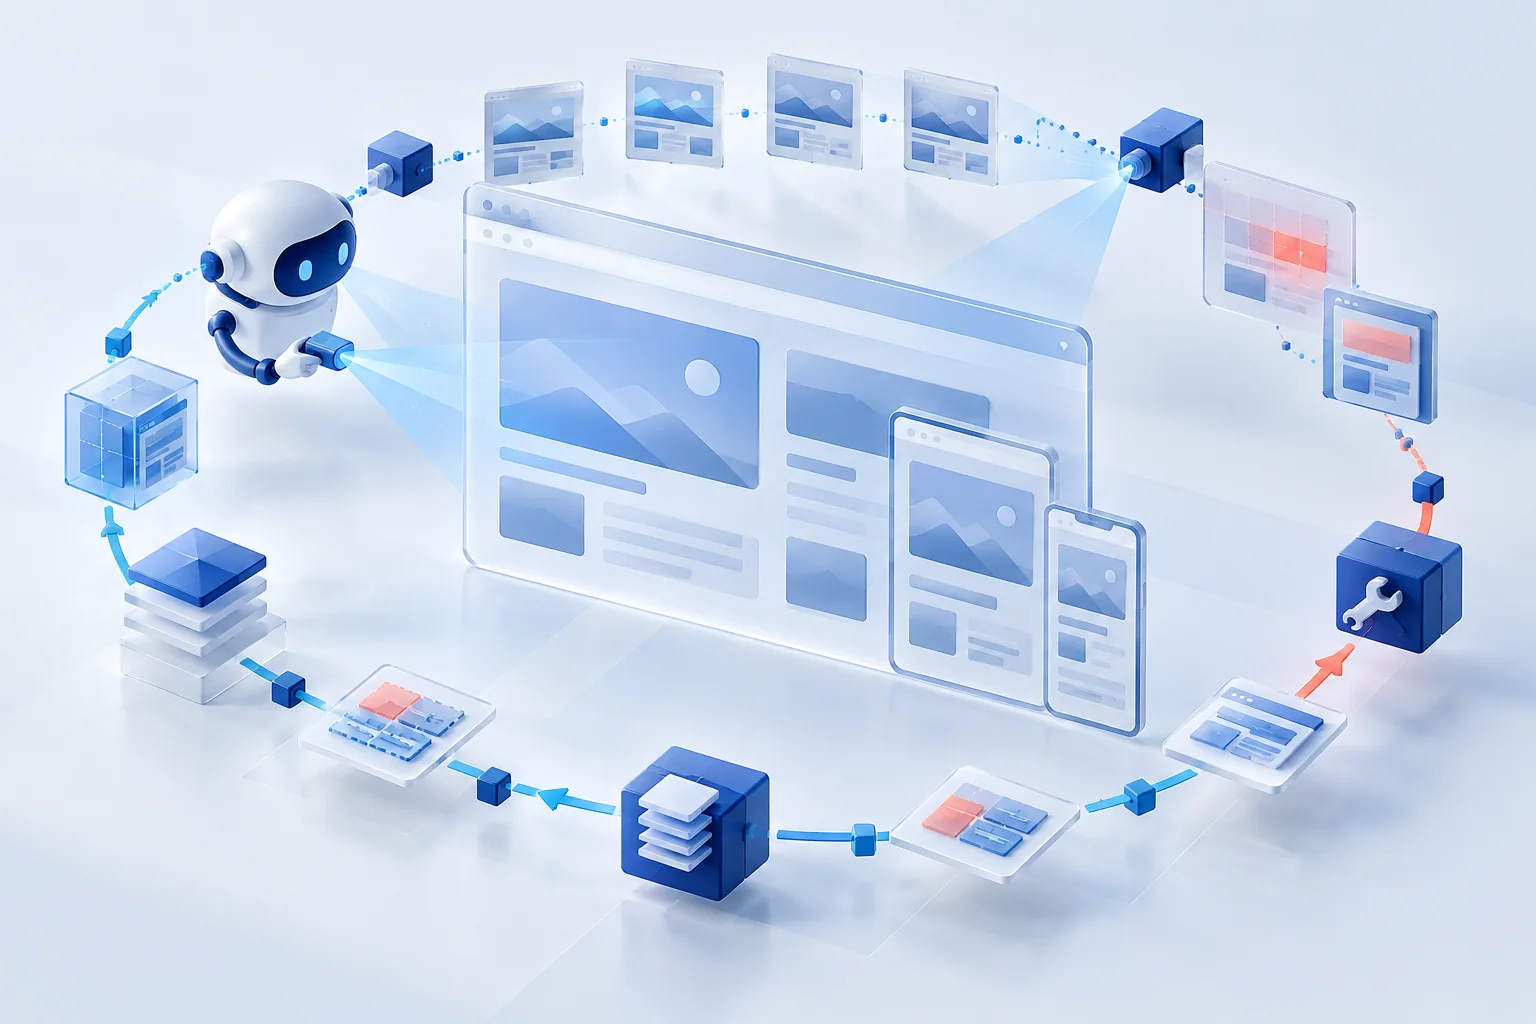
La siguiente arquitectura separa el control empresarial de la ejecución del agente. La tecnología de backend sigue gestionando autenticación, proyectos, conversaciones, versiones, créditos y persistencia. Un plano de ejecución especializado mantiene conversaciones largas con el modelo, opera sobre un workspace aislado y utiliza Chromium para ver la aplicación real.
Arquitectura experimental
Usuario
lenguaje natural
Mikodawa Studio
interfaz y control
Agent Core
herramientas y workspace
Chromium
render, interacción y visual QA
Benchmark
métricas comparables
El ciclo de herramientas conserva la conversación nativa: una llamada produce una salida, esa salida vuelve al modelo y el agente decide el siguiente paso. Operaciones como apply_patch permiten cambiar fragmentos concretos sin reescribir archivos completos. Las referencias permanecen separadas de los artefactos hasta que el agente decide importarlas al proyecto.
La diferencia decisiva es Chromium. Studio puede revisar la aplicación en escritorio, tableta y móvil; recoger errores de consola, imágenes rotas y desbordamientos; y probar menús, formularios o modales. El proceso se acerca al bucle real de un equipo de desarrollo: editar, ejecutar, mirar y corregir.
06 · Comparar sin ventajas ocultas
Dos motores, el mismo experimento
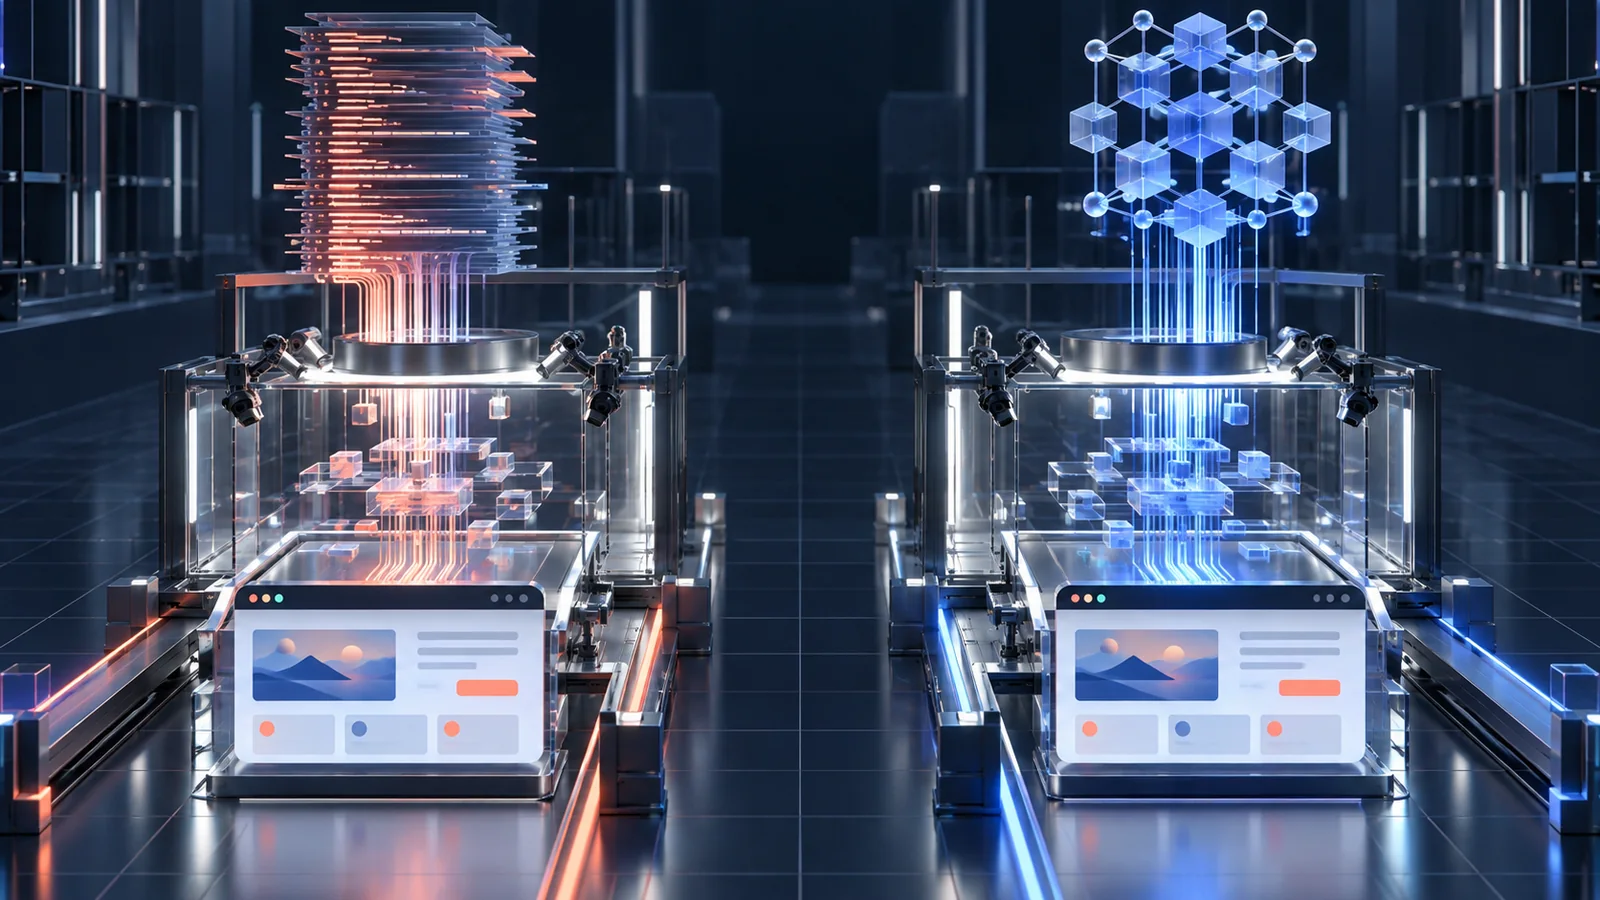
Agent Core debe convertirse primero en un baseline tradicional fiable. Un motor construirá con React, TypeScript y CSS. El otro trabajará con la futura representación de Runtime. Ambos recibirán el mismo prompt, los mismos recursos, el mismo tiempo y los mismos límites. Después pasarán por el mismo navegador, las mismas pruebas y el mismo revisor.
07 · Convertir intuición en datos
Cómo sabremos si funciona
Una demo atractiva no basta. La comparación necesita observar el coste de crear una aplicación y el de hacerla evolucionar. Cambiar el tema, añadir autenticación, incorporar una página o adaptar el menú a móvil puede revelar diferencias que no aparecen en la primera generación.
Coste
Tokens, créditos y coste monetario
Tiempo
IA, build, validación y reparación
Complejidad
Archivos, líneas y operaciones
Fiabilidad
Errores, reintentos y reparaciones
Calidad
Responsive, accesibilidad y función
Evolución
Coste de modificar lo ya construido
Hipótesis teórica
Ahorro que esperamos poner a prueba
Índice relativo. Enfoque tradicional = 100.
Consumo de tokens
−55%
Energía asociada
−45%
Estas métricas no sustituyen el juicio sobre la calidad, pero evitan que una impresión visual aislada se convierta en una afirmación técnica. Cada ejecución debe dejar un rastro que pueda revisarse y compararse.
08 · Límites actuales
Lo que todavía no sabemos
Runtime no ha demostrado que reduzca tokens, sea más rápido, produzca menos errores o genere mejor software. Tampoco sabemos cuánto detalle debe contener su representación intermedia, cómo se mantendrá comprensible cuando crezca una aplicación o qué partes seguirán siendo más eficientes en lenguajes tradicionales.
Existe además una posibilidad importante: que la ventaja no aparezca en la primera generación, sino al comprender y modificar sistemas grandes. También puede ocurrir que solo sea útil para determinados targets o tipos de proyecto. Un resultado negativo sería igualmente valioso si explica dónde están los límites.
Una investigación, no una promesa
Publicaremos hipótesis, decisiones y resultados conforme el banco de pruebas sea reproducible. Las conclusiones llegarán después de los datos.
Los próximos pasos
- Estabilizar Agent Core con generación tradicional y visual QA.
- Consolidar un target de referencia basado en Vite, React y TypeScript.
- Automatizar benchmarks repetibles con prompts y pruebas comunes.
- Definir una primera versión mínima de Runtime IR.
- Ejecutar la misma batería con ambos motores y comparar evidencias.
- Modificar Runtime a partir de las fricciones observadas, no de la teoría.
Quizá la próxima optimización importante en programación con IA no consista solo en crear modelos más capaces. Quizá también debamos cambiar la interfaz con la que les pedimos que construyan software.
Mikodawa Studio es el laboratorio para responder esa pregunta. Mikodawa Runtime es la hipótesis. El trabajo que empieza ahora consiste en convertirla en algo que pueda medirse.
Investigación Mikodawa